先说结论 MCP Toolbox 很适合小团队研究“让 AI 安全查数据库”,但第一步不该接生产库,更不该给通用写权限。
适合 有测试库、只读账号、工程同学陪跑,想让 AI 辅助查 schema、查指标、写数据分析草稿的小团队。
不适合 只有生产库账号、没有权限分层、希望 AI 直接改数据或自动做经营决策的人。
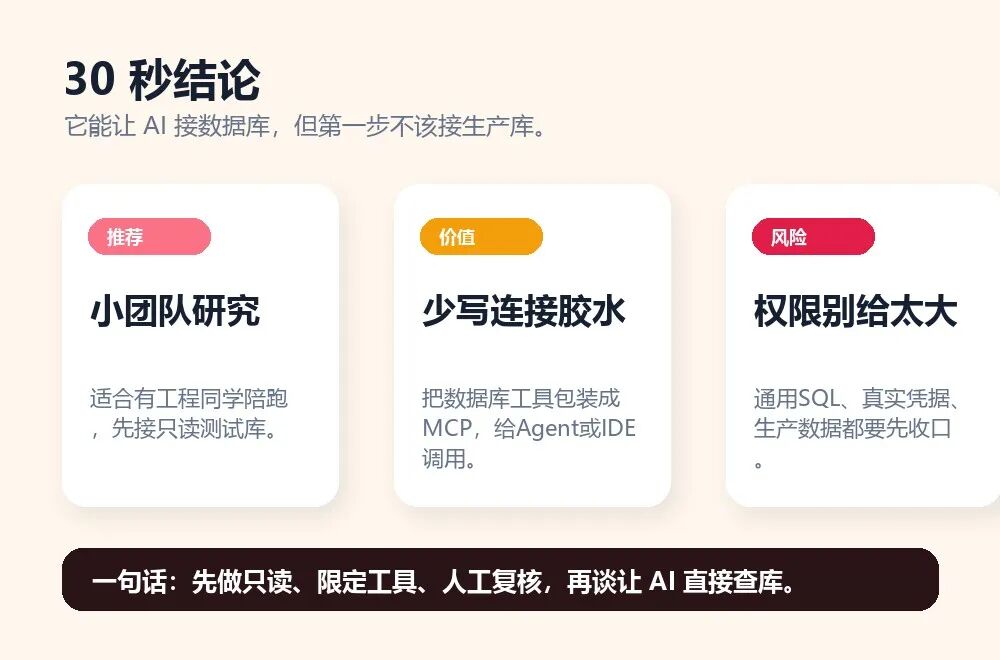 30 秒结论卡
这个项目最近很容易让人心动。
但如果你只是想找一个马上能替你干活的工具,我建议先把这几个限制看完。
项目地址是 https://github.com/googleapis/mcp-toolbox 。截至 2026-07-14,我用 GitHub API 看到它有 15,953 stars、1,636 forks,仓库最近一次 push 是 2026-07-14T10:53:33Z;最新 release 是 v1.6.0,发布时间是 2026-07-01T00:28:13Z。
这些数字说明它不是一个没人维护的小玩具。但“活跃”和“适合马上接生产数据”是两回事。
它解决什么问题
MCP Toolbox for Databases 想做的事情很直接:把数据库能力包装成 MCP server,让 Gemini CLI、Claude Code、Codex 或其他 MCP 客户端能通过工具去访问数据库。
从 README 看,它支持两条路线。
预置工具:例如连接 Postgres 后给 AI list_tables、execute_sql 这类通用能力。
自定义工具:用 tools.yaml 把数据源、查询、参数和 toolset 收口,只暴露你允许 AI 调用的动作。
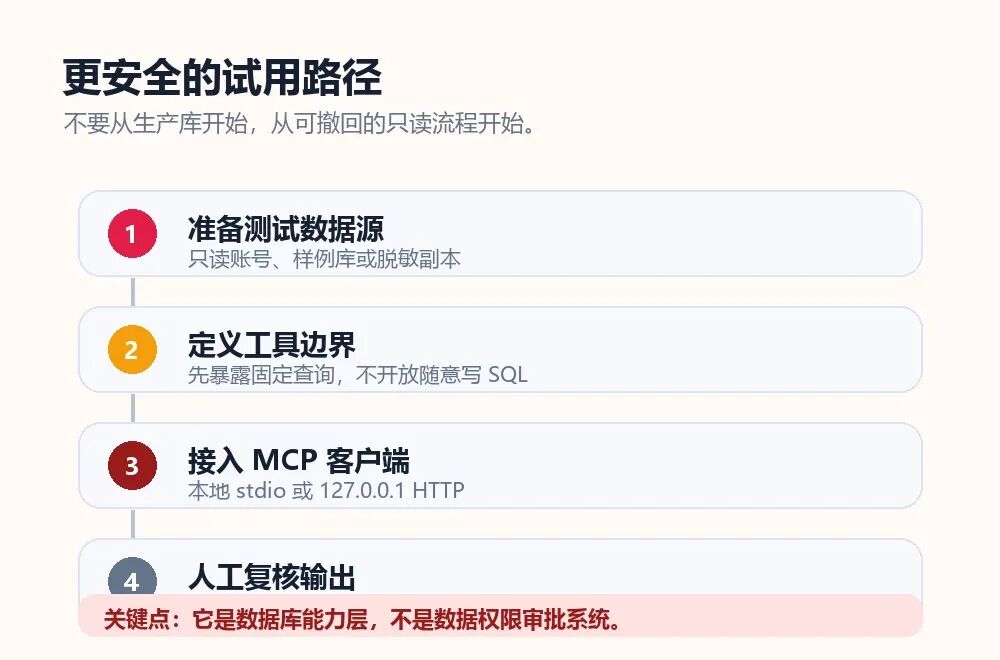 更安全的试用路径
对小团队来说,诱惑点很明显:以前运营想查一个指标,要找研发写 SQL;接上 MCP 后,AI 可能帮你探索表结构、生成查询、整理结果。
但问题也在这里:数据库不是普通网页。它里面可能有客户、订单、财务、员工和业务机密。AI 多一步能力,就多一个权限边界要管理。
我实际验证了什么
我这次做的是轻量安全检查,不连接任何真实数据库。
实测范围
2026-07-14,我核验了 GitHub 仓库、README、release、LICENSE、go.mod、npm 包元数据,并在本机运行了 npx --yes @toolbox-sdk/server --help。help 能正常输出,列出了 serve、invoke、migrate、skills-generate 等命令,也能看到 --prebuilt 支持 Postgres、MySQL、BigQuery、SQLite、Snowflake、Neo4j、Redis 等数据源类型。
本机环境里 Node 是 v24.13.0,npm 是 11.6.2;go version 和 docker --version 都不可用。所以我没有用 Go 编译,也没有跑 Docker。
我没有验证这些内容:没有配置数据库账号,没有执行 SQL,没有调用任何模型 API,没有测试 Google Cloud IAM,也没有把它接到真实 MCP 客户端里跑业务流程。
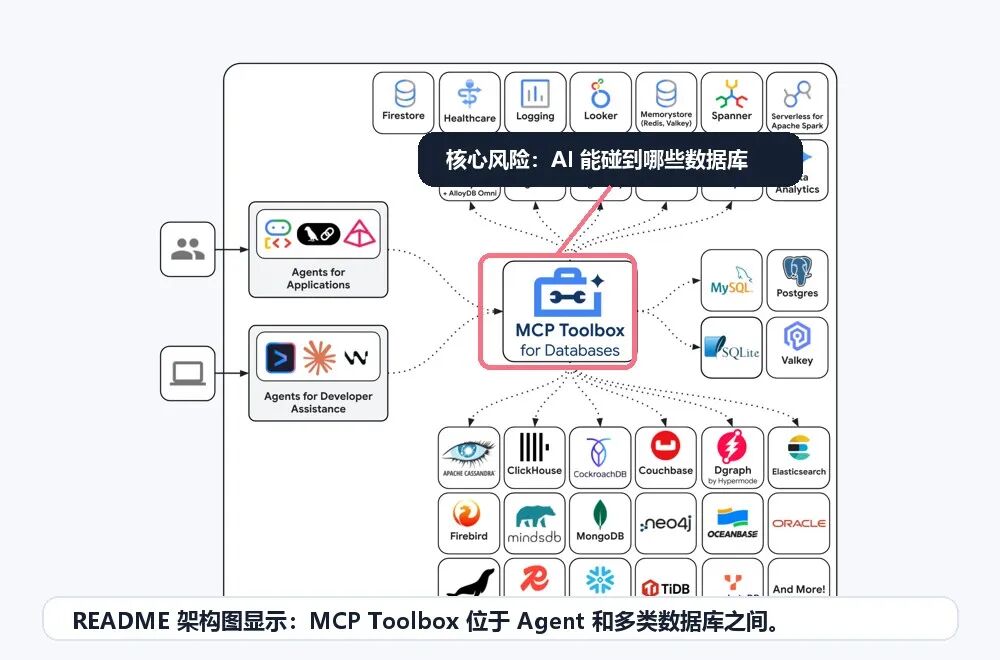 项目截图标注
安装门槛要分三层看。
想快速试:README 给了 npx @toolbox-sdk/server --config tools.yaml 这条路线。
想稳定部署:README 更推荐二进制或容器镜像;我用 HEAD 请求核验到 v1.6.0 Windows amd64 binary 可访问,大小约 285MB。
想从源码编译:go.mod 写的是 go 1.25.8,并声明 toolchain go1.26.4。
许可证方面,仓库是 Apache-2.0。硬件方面,它本身不是模型推理工具,不需要 GPU;真正的门槛是数据库凭据、MCP 客户端、网络权限,以及你用哪家模型服务来理解用户问题。
先别急的几个坑
第一个坑:不要把通用 SQL 能力直接给生产库。
README 里预置工具的价值在于上手快,比如 execute_sql 很适合探索。但对普通团队来说,这也是最容易失控的地方。哪怕只读账号,也可能查到不该被 AI 看到的数据。
第二个坑:数据库账号不是“填进去就完了”。
你至少要考虑只读账号、字段脱敏、表级权限、查询超时、审计日志、IP 限制和凭据轮换。没有这些基础,MCP 只是把风险包装得更方便调用。
第三个坑:HTTP 服务别随手暴露。
help 里能看到默认监听地址是 127.0.0.1、默认端口是 5000,也有 --stdio。这对本地试用是好事。但如果你为了远程访问改成 HTTP,就要认真配置允许的 host、origin、TLS 和网络边界。
第四个坑:自然语言查数不等于经营结论。
AI 可以帮你生成 SQL 或解释结果,但它不知道你的指标口径。比如“本月活跃客户”到底按登录、下单、支付还是续费算,仍然需要人定义。
第五个坑:小团队最缺的不是工具,而是数据治理。
如果你们现在连表名、字段含义、敏感字段、指标口径都没有文档,直接让 AI 进库,通常只会把混乱放大。
它适合谁
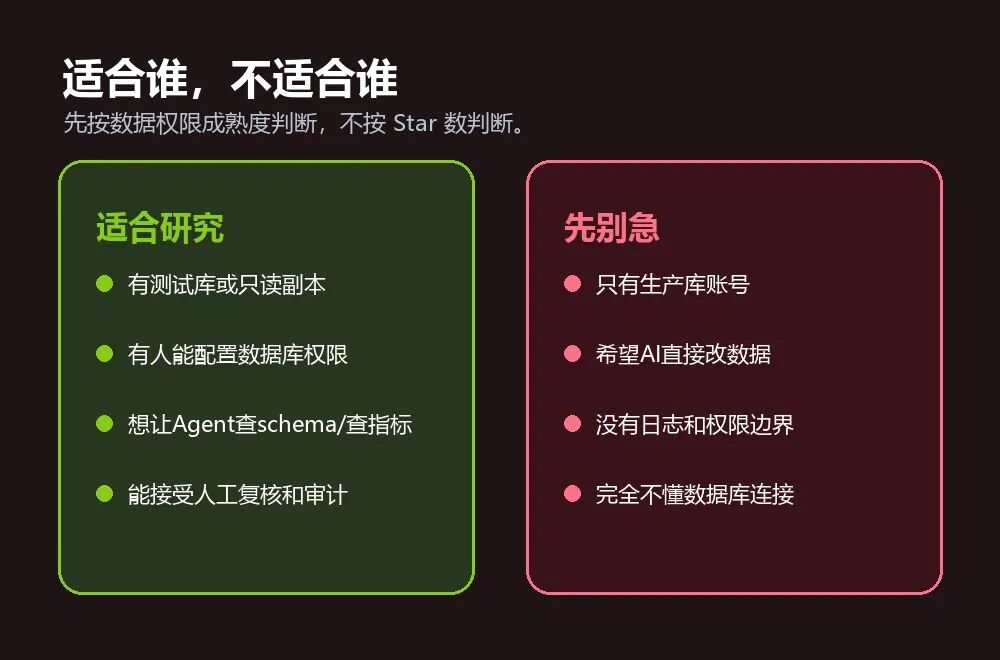 适合谁,不适合谁
我认为它更适合这几类人。
有内部数据分析需求的小团队:想让 AI 帮忙查指标、生成分析草稿,但愿意先做只读和脱敏。
做 AI Agent 原型的产品或研发:希望少写数据库连接胶水,把数据源封装成统一工具。
有明确数据源的运营团队:例如客服工单、订单状态、内容库、库存表,能先从一两个低风险查询开始。
我的判断 MCP Toolbox 的价值不是“让普通人随便问数据库”,而是让团队用更标准的方式,把数据库能力交给 Agent;真正值得投入的是权限设计和工具边界。
这周怎么低风险试
如果这周就想试,我建议不要从公司生产库开始。
先做一个最小流程:
准备一个样例库或只读测试库,最好是脱敏数据。
只开放 1-2 个固定查询,比如“按日期查订单数量”或“按渠道查线索数”。
用 tools.yaml 明确数据源、参数和 SQL,不要一开始就开放通用写入。
让 AI 只生成草稿结论,所有数字解释都由人复核。
试运行一周后,再决定是否增加表、字段和查询场景。
3 分钟判断:
如果你有测试库、只读账号和工程同学陪跑,可以先研究 MCP Toolbox。
如果你只有生产库账号,先别接 AI,先做权限分层和脱敏。
如果你想让 AI 自动改库存、改订单、改财务数据,暂时不要折腾。
最后总结一下:
先说结论 MCP Toolbox 值得小团队研究,但不适合无脑接生产库。
适合 有数据库治理意识、想让 AI 辅助查数和分析的小团队。
注意 先做只读、限定工具、人工复核;把它当数据库能力层,不要当数据安全系统。
推荐标签:适合小团队研究。
[登录查看剩余 70% 内容](javascript:void (0);)