你给AI喂的"企业记忆",可能全是假的
几乎所有的企业AI落地,都在犯同一个错误:以为把数据喂给AI,AI就会变聪明。
错了。AI不会变聪明。它只会把你喂的数据,用更漂亮的方式说出来。
如果你的数据本身在打架,AI输出的就是包装精美的错误。
想象这样一个场景:老板问AI助手,"A项目现在什么进度?"AI沉默五秒,给出了一个工整、清晰、信心满满的回答——"85%,预计按时交付"。
但老板的脸黑了。
因为他上周刚在项目会上听负责人说"大概率要延期"。会议纪要写的是"进展顺利,风险可控",周报写的是"本周完成联调,进入测试",禅道系统里显示的任务进度是55%。
同一个项目,三个来源,三个数字,AI选了一个最漂亮的。
这不是AI的问题。是你用来喂AI的数据,本身就在打架。
一、你喂给AI的不是记忆,是碎片
今天几乎所有做AI落地的企业,都在干同一件事:把会议纪要、周报、项目管理系统、IM讨论、邮件往来全灌进知识库,想着AI从此无所不知。
但你没想过——这些数据自己就在互相矛盾。
会议纪要说"进展顺利",实际项目进度停了两周。
周报写"联调完成",禅道里对应的任务状态还是"开发中"。
IM里讨论的是"方案A",最后邮件拍板的却是"方案B"。
每一条数据单独看都没问题。放到一起,AI根本不知道该信谁。
更可怕的是,AI不会告诉你"我看到了矛盾信息"。它只会根据概率,选一个看起来最合理的答案,然后自信满满地输出一个错误结论。
你给AI的不是"企业记忆",是一堆各自为政的信息碎片。
二、你缺的不是数据,是一条"可信化流水线"
问题不只是"数据脏",而是"数据之间没有验证机制"。
你需要的不是更干净的单个数据源,而是一条数据可信化流水线——让不同来源的数据自动比对,发现不一致,然后让人来确认到底哪个是对的。
这条流水线,五步走完。
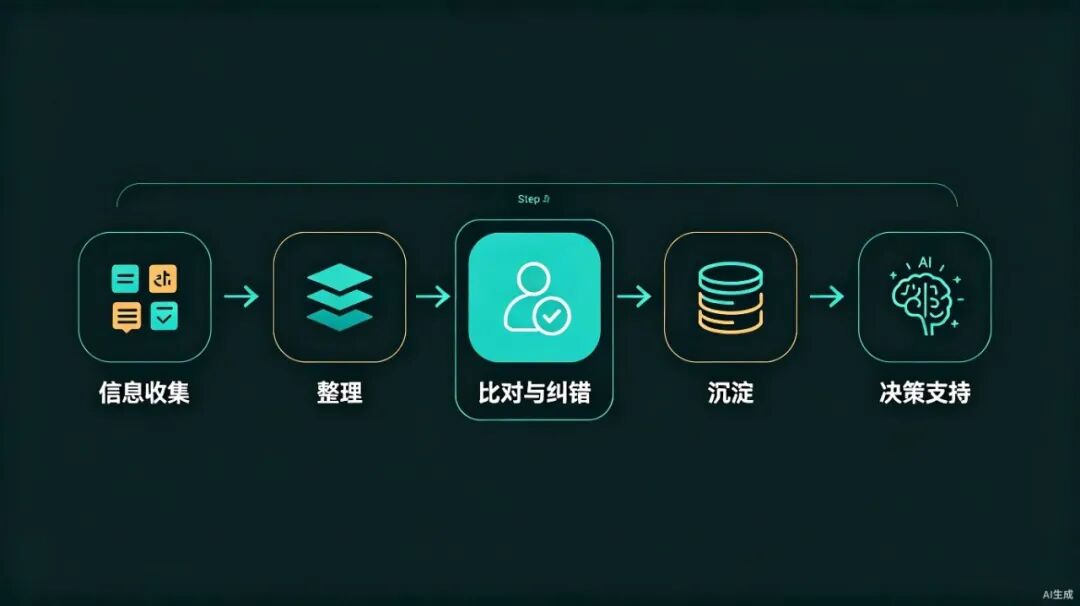
第一步:信息收集。
把散落在各处的数据先拉进来。会议录音、周报口述、禅道任务、IM讨论、邮件往来——不管是什么格式,先进来再说。你永远不知道哪个数据源会在比对时派上用场。
这里有一个关键设计:数据不是一视同仁的。不同来源的数据有不同的可信度基线。系统同步过来的结构化数据,比口头描述的可信度更高;人工确认过的数据,比AI推断的可信度更高。这个优先级在采集时就要埋进去。
第二步:整理。
拉进来的数据是毛坯,需要加工成统一规格。每一条数据都要明确:它属于哪个项目、什么阶段、什么主题。
这里引入一个关键概念——金字塔分层。不是简单存一份原始文本了事,而是把数据按稳定性和重要性分成五层:
L1原则层,企业的价值观、合规底线、AI行为约束。这层最稳定,一年变不了几次,但一旦被突破,后果最严重。
L2架构层,技术选型、架构决策、依赖关系。这层半年到一年更新一次,是团队做决策的框架。
L3规范层,编码规范、接口契约、SOP流程。这层按月更新,是日常工作的操作手册。
L4实现层,API文档、代码、配置、当前项目状态。这层按周更新,是AI最频繁调用的数据。
L5经验层,故障复盘、踩坑记录、会话摘要、临时方案。这层每天都在产生,保鲜期最短,但往往是解决问题的第一手资料。
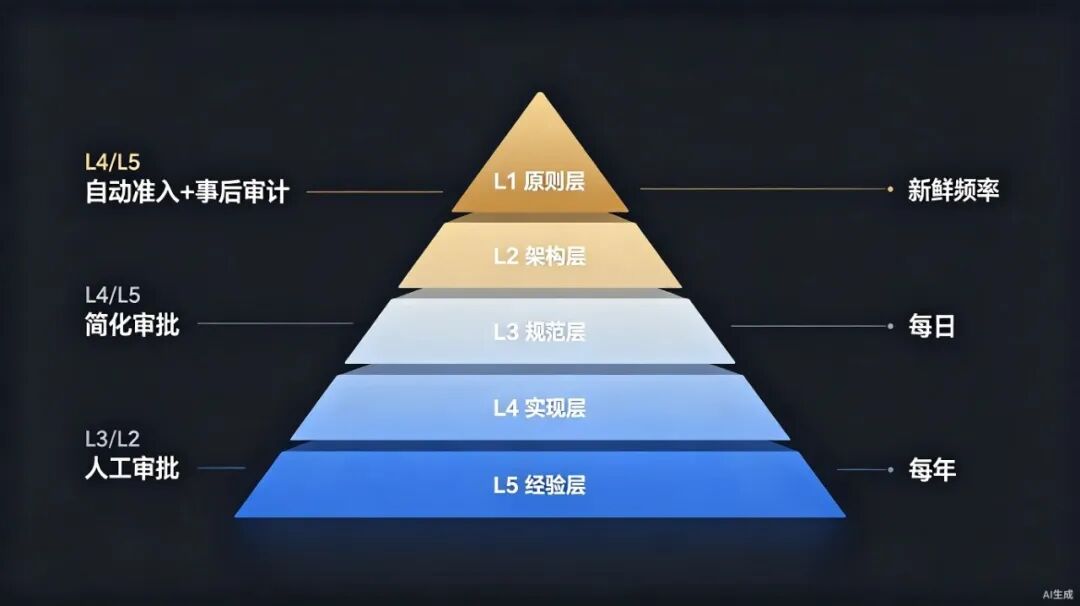
为什么要分五层?因为不同层级的数据,需要不同的治理策略。L1和L2变更少但影响大,需要人工审批才能入库。L4和L5变更频繁但风险低,可以自动准入+事后审计。L3居中,走简化审批。
没有分层,要么高价值数据被淹没在噪音里,要么低风险数据卡死在流程中。
还有一个延伸问题:分层之后,无论是人类员工还是数字员工(Agent),访问哪一层的数据、能做什么操作,都基于同一套权限策略。Agent启动时继承唤醒者的权限,且不得超过该角色的上限——这是数字员工的"最小知情原则"。不过关于Agent权限体系的完整设计,我们在之前的文章里已经展开聊过,这里点到为止。
第三步:比对与纠错。
这是整条流水线的核心——也是绝大多数产品完全没做的事。
你把会议录音里提取的进度,跟禅道系统里的进度,跟周报里的进度,放在一起逐字段比较。
阶段一致吗?进度偏差大吗?负责人对得上吗?截止时间有没有冲突?
比对结果只有四种:完全一致、有冲突、只有语音说了系统没记、只有系统记了但没人提过。
一致的,自动提升可信度。冲突的,推给人去处理。单源的,标记来源待后续验证。
这里有个反直觉的设计:比对规则用结构化规则实现,不依赖AI判断。
为什么?因为冲突 detection 必须是确定性的——进度差超过30%就是冲突,不需要AI来"感受"。AI只负责解释冲突——比如"语音说项目在执行阶段,禅道显示还在规划,建议确认一下是否已启动"。
让规则做判断,让AI做解释。这是数据可信化流水线里一个关键的职责分离。
第四步:沉淀。
比对确认后的数据,才真正进入"组织记忆"。
它的形态不是一堆文档,而是一条时间轴——每个项目发生了什么、谁在什么时候做了决策、什么数据在什么时候被确认过。你往回翻,能看到完整的演变过程,而不是一堆孤立的快照。
第五步:决策支持。
有了可信的数据基础,AI才能做真正有价值的事:预警进度偏差、识别项目停滞、发现逾期风险、回答管理层的自然语言问题。
没有前四步,第五步就是空中楼阁。AI越聪明,错得越离谱。
三、数据也需要"免疫系统"
比对完了,怎么保证数据不会随着时间腐坏?
你需要一个巡检者——系统的免疫系统,持续运转,自动发现问题。
它的核心任务有四类:
发现过期:检测数据内容是否与当前实际情况不一致。比如文档里写的版本号已经过期,或者某条规范已经被新规范替代。
发现冲突:识别不同文档或不同系统之间的逻辑矛盾。比如A文档说依赖B服务,B文档却说没有这种依赖。
发现缺口:找到孤立节点或缺失的规范。比如某个项目有需求文档但没有对应的接口契约。
层级校验:检查数据内容是否下沉到了正确的层级。比如L2架构层里不应该塞满L4实现层的代码细节。
巡检者不是一次性跑批的ETL任务,而是持续运转的后台进程。不同层级的巡检频率也不同:L1按年巡检,L2按季,L3按月,L4按周,L5按日。
发现问题后,不是直接修改,而是标记状态→触发工单→进入审批流→人工确认后更新。
这套机制的本质是:数据不是灌进去就完事了,它需要持续被验证、被修正、被更新。
四、这跟数据中台不是一回事
有人可能会问:这不就是数据中台吗?把各个系统的数据汇聚到一起,做清洗、做治理,然后给上层应用用。
不完全是。两者解决的是不同层面的问题,更像是互补关系。
数据中台的核心逻辑是"汇聚→标准化→统一视图"。它的目标是让分散的数据能被找到、能被使用。数据中台回答的问题是:"数据在哪?怎么找?"
可信化流水线的核心逻辑是"收集→整理→比对→确认→沉淀"。它的目标不仅是要找到数据,还要验证数据对不对。它回答的问题是:"这些数据可信吗?该信谁?"
打个比方:数据中台是修路——把分散的数据源用管道连起来,让数据能流通。可信化流水线是设安检——数据流过管道之后,还要检查有没有矛盾、有没有过期、有没有缺漏。
没有路,安检无从谈起;没有安检,路上跑的可能都是带病的数据。
具体有四个关键区别:
第一,治理目标不同。
数据中台治理的是"数据质量"——字段格式对不对、缺失值多不多、数据类型是否统一。可信化流水线治理的是"数据可信度"——不同来源的数据是否一致、有没有冲突、谁确认过。
前者回答"数据干净吗",后者回答"数据可信吗"。
第二,治理方式不同。
数据中台的治理是"自上而下建模"——先定义数据标准,再按标准清洗。可信化流水线的治理是"自下而上比对"——从不同来源采集数据,自动发现不一致,通过人工确认闭环逐步提升可信度。
第三,时效逻辑不同。
数据中台通常是批量ETL——每小时或每天跑一批。可信化流水线是事件驱动——一条新数据进来,立刻触发比对,发现冲突立刻推送,确认后立刻更新可信状态。
第四,产出形态不同。
数据中台的产出是统一的数据资产目录、数据服务API、BI报表。可信化流水线的产出是可信状态——每个项目当前的真实进度、每条数据的可信度评分、每个决策的完整追溯链。
简单说:数据中台让AI找得到数据,可信化流水线让AI敢用数据。
五、回到那个场景
现在再回头看那个场景。
老板问AI项目进度,AI给了一个漂亮但错误的答案。问题出在哪?
不是大模型不够强,不是知识库不够大,不是AI助手不够聪明。
是他给AI喂的是"会议纪要+周报+禅道数据"三个互不验证的信息源。AI不傻,它只是没人告诉它"这些数据之间可能有冲突,你需要先验证再使用"。
企业记忆不是把数据堆在一起,而是让数据之间互相验证。
你的AI越聪明,它就越需要可信的数据。否则,你得到的不是智能,是包装精美的错误。
这篇文章的思路,来自一套完整的企业级记忆系统架构构想。是对企业AI落地中一个被忽视问题的追问:当大家都在忙着给AI建知识库,有谁先问过一句——仓库里的数据,真的可信吗?
如果这个问题戳中了你,说明你不是缺AI,是缺数据治理。
[登录查看剩余 70% 内容](javascript:void (0);)