我们总以为,把 Agent 做好,关键在于换一个更强的模型,或者把提示词写得更长、更细。
但真正进入一线场景后会发现,模型能力只是起点。Agent 能否稳定完成任务,还取决于它如何被引导,上下文如何被组织,工具和权限如何接入,结果如何被验证,以及 Harness 如何把一次次不确定的模型输出,转化为更稳定、可控的执行过程。
这篇文章邀请 WorkBuddy 团队策略产品经理 Anne,从产品视角拆解 Agent 的运行机制。她负责 WorkBuddy 研发与办公场景 AI Agent 的上下文策略设计与落地,是腾讯内部「上下文工程」方向最贴近一线的实践者之一。文章不堆叠概念,而是沿着“模型—上下文—Harness—Loop”的链路,讲清楚 WorkBuddy 如何把 Agent 从模型能力推进到可用产品能力。
从模型到Harness:
WorkBuddy如何把Agent做成可用产品
作者:Anne WorkBuddy策略产品经理
一个常见判断是“模型够强,剩下交给提示词”。但把 Agent 做成能在生产环境稳定完成任务的产品后,会发现模型只承担其中一部分:工具接入、上下文组织、权限边界、结果验证、反馈纠正和跨会话延续,都会直接影响产品是否可靠。
这篇文章分成两部分。前半部分面向还没有 Agent 基础的同学,先讲清大语言模型(LLM)、工具调用(Function call)、 系统提示词(System Prompt)、模型上下文协议(MCP)、技能 (Skill)和 插件(Plugin) 这些基础概念,说明模型为什么需要产品侧提供工具、上下文和执行环境。
后半部分回到 WorkBuddy 的产品实现,重点讨论 Context Engineering 和 Harness Engineering:WorkBuddy 如何选择和组织上下文,如何通过前馈、反馈、权限、验证、编排和可观测性,让 Agent 不只是能执行任务,而是能更稳定、更可控地完成任务。最后再简要讨论 Loop Engineering,说明这套机制如何进入长期任务循环。
阅读时可以带两个视角:作为构建者,看这些工程如何提高 Agent 执行任务的可靠性;作为使用者,看如何更有效地使用 AI Agent 产品。
一、先把模型看成一个无状态的函数
对产品侧而言,不需要展开 Transformer 的底层原理,只需要一个抽象:模型是一个根据输入产生后续文字的函数。
模型能力来自三个训练阶段:
1. 预训练(pre-training):模型在海量文本上反复执行“根据前文预测下一个 token”,习得语言、世界知识和部分推理能力。这一阶段的模型只能根据已有文本续写后续内容。
2. 后训练(post-training):用问答、工具调用、安全边界等数据,把基座模型训练成能听指令的助手。这一阶段后,模型对“中国的首都是哪里”会回答“北京”。
3. 偏好优化与强化学习(Reinforcement-learning):面对多个候选回答或操作路径时,用人类反馈和评分提高模型选中更有用、更正确选项的概率。对一个步骤组合很多的任务,训练时按结果质量、效率和规范给不同打分,反复之后模型收敛到更优的执行路径。
经过这些训练阶段后,我们得到的是一个具备大量基础知识、能够理解并遵循人类指令的模型。从产品运行机制看,一次模型调用可以类比为一个函数:
输出 = 模型 (系统提示词 + 工具 + 会话历史 + 其他上下文 + 用户指令)
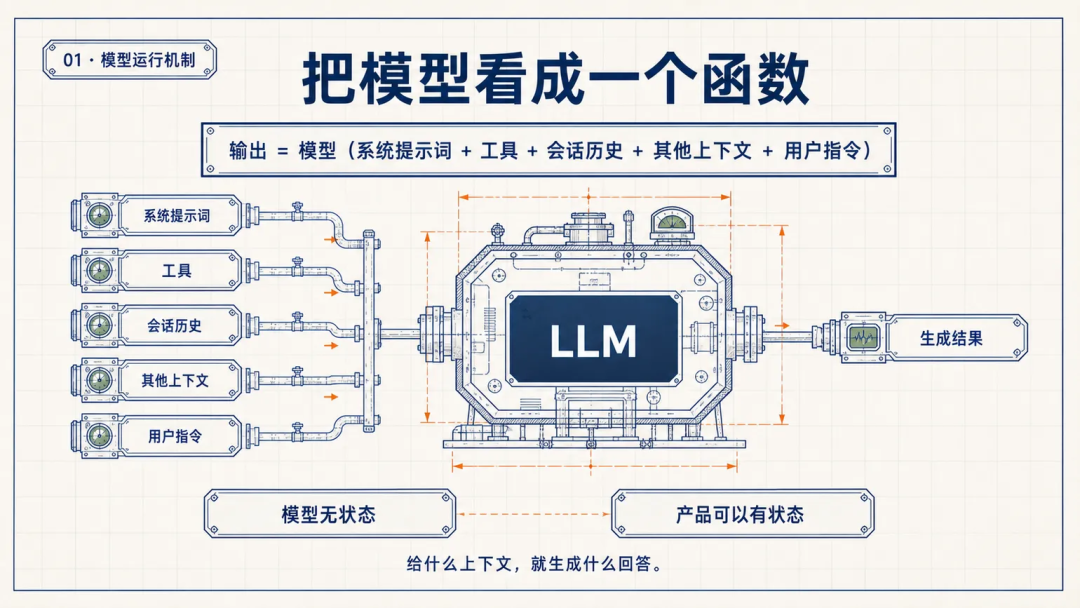
图:模型调用抽象
这个抽象包含两条约束,决定了上层所有工程的存在理由:
**1. 模型是无状态的。**它不会自动保留上一次调用的内容。模型虽然无状态,但产品可以有状态。对话历史、Memory、数据库由产品在模型外部保存,需要时再放进本次输入。WorkBuddy 的对话连续性、记忆和工作进度,都由产品侧维护状态再注入实现,模型本身不承担存储。
**2. 模型的知识截止到训练日期。**训练之后发生的事,模型默认不掌握。询问训练日期之后的实时信息时,模型无法回答,需要先用工具查询再放进上下文。
也就是说,模型本身提供的是语言理解、推理和生成能力;但像“当前世界杯赛况”这类实时信息,或者读文件、查数据库这类外部动作,都不是模型自带的能力。产品需要在模型外接入工具和执行环境,让模型知道有哪些工具可用,并把执行结果回传给模型。
这就引出了 Agent 的基础机制:工具调用。
二、用户能感知到的四个概念:工具调用 / MCP / Skill / Plugin
工具调用:模型怎么请求执行动作
工具调用(也常叫 function call、Tool Call)是模型与外部系统之间的结构化协议:模型负责生成调用请求,Agent 负责执行。
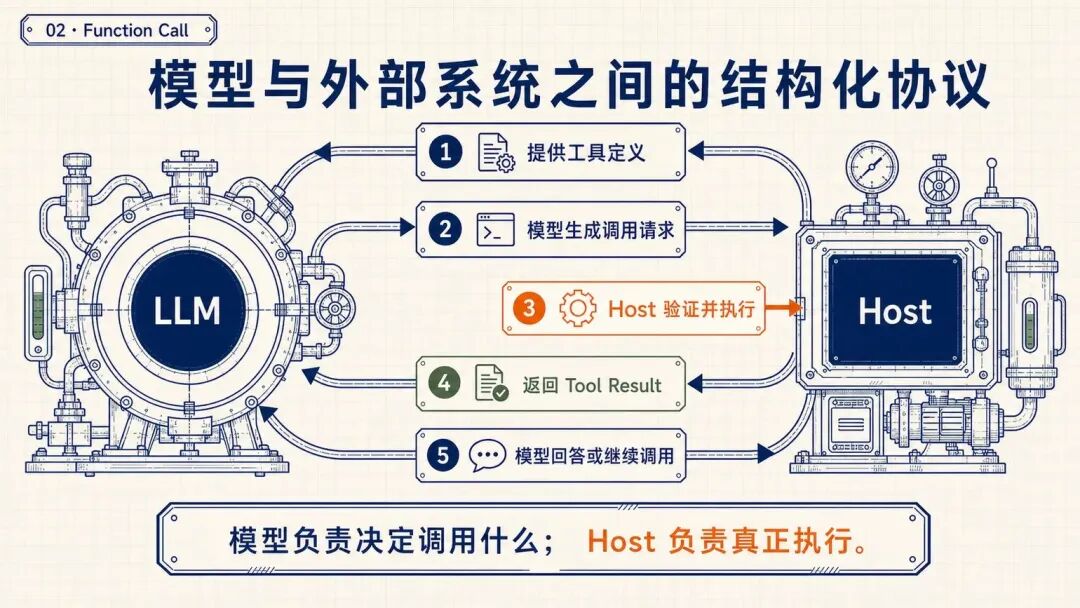
图:工具调用流程
完整流程:
产品把可用工具的名称、用途和参数 Schema 提供给模型;
模型根据用户目标,输出一个结构化的调用请求;
Agent 校验参数、检查权限,执行 API、脚本或本地函数;
Agent 把执行结果作为 tool result 放回上下文;
模型读取结果,决定直接回答还是继续调用其他工具。
一个示例工具定义如下,它作为上下文提供给模型:
{ "type": "function", "name": "get_match_status", "description": "查询指定赛事在指定日期的实时或最终赛况。用户询问比分、开赛时间、进球者或赛果时使用。", "parameters": { "type": "object", "properties": { "competition": { "type": "string", "description": "赛事名称,例如世界杯或英超" }, "team": { "type": "string", "description": "球队名称" }, "date": { "type": "string", "description": "YYYY-MM-DD;未提供时由宿主按用户时区取当天" } }, "required": ["competition", "team"], "additionalProperties": false }}
下图展示了一次工具调用的完整执行过程:用户提出查询请求后,模型根据工具定义生成工具调用;Agent 收到请求后校验参数和权限,再去获取实时的数据;工具返回结果后,模型读取工具执行结果,并基于结果生成最终回答。
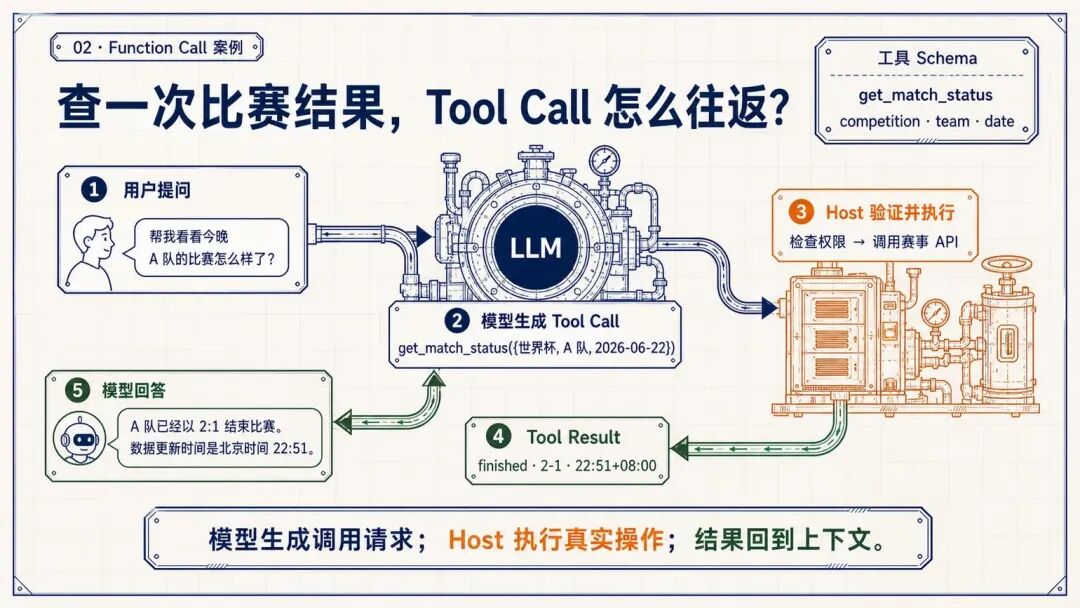
图:工具执行过程示例
这里有一个容易被忽略的要点:持有 API Key、发起请求、修改数据的是 Agent,不是模型。模型负责生成调用请求,Agent 负责执行外部操作。因此,权限、审批、参数校验和审计日志都必须由模型外部的工程机制执行。把这些校验放在 Agent 执行层,是高风险操作能被拦下的前提。
System Prompt:给 Agent 一个稳定的工作角色
有了工具调用,Agent 具备执行能力,但还缺少稳定的工作角色。同一个模型既能写诗也能改代码、查数据;WorkBuddy 需要它在每次运行中都明确:自己是什么产品、能做什么、按什么原则工作、什么情况必须停下来询问用户。
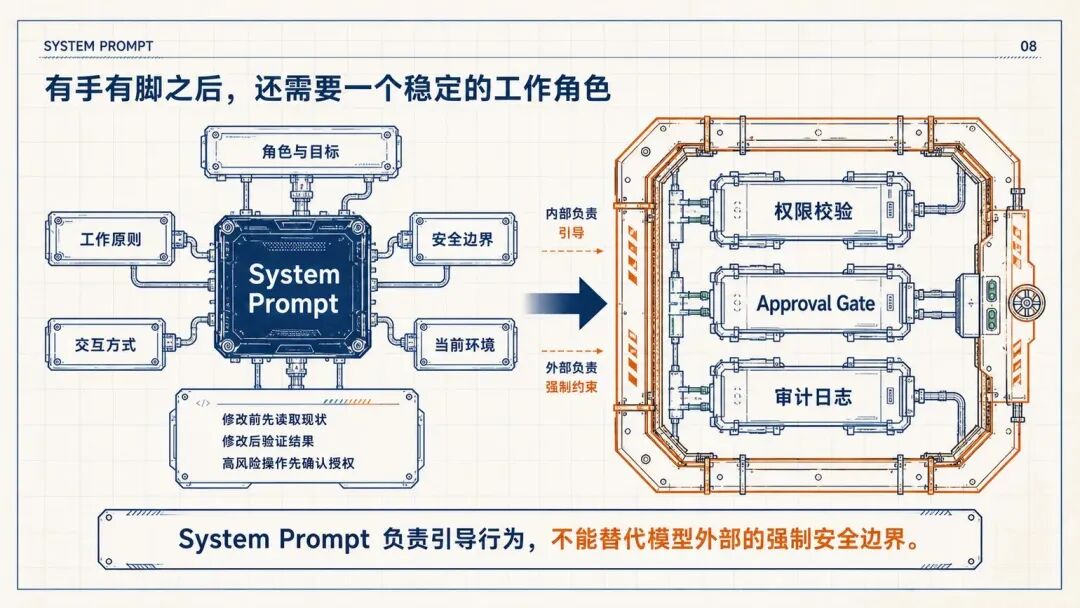
图:System Prompt 的作用
System Prompt 定义当前产品和本次运行的高优先级工作契约,通常包含:
• 角色与目标:你是一个能读写文件、运行命令、操作浏览器的工作助手。
• 能力地图:哪些工具可用,何时查资料、读文件、验证结果。
• 工作原则:先理解目标再执行;长任务先拆分;修改后要测试;不确定时不猜。
• 安全与权限边界:删除、发送、支付、发布等高风险动作需要审批。
• 交互风格:使用用户选择的语言,进度更新简短,最终结论清晰。
• 当前环境:操作系统、Shell、时间、工作目录等运行时信息。
你是 WorkBuddy。你可以使用文件、Shell、浏览器和已连接的业务工具完成任务。修改前先读取现状;修改后用可观察的方式验证。发送、发布、删除或其他不可轻易撤销的操作,执行前确认用户授权。
**System Prompt 只能引导,不能强制。**权限校验、Sandbox、Approval Gate、审计仍由模型外部的系统执行。这个区别在 Harness 章节会反复出现。System Prompt 也不该承载所有信息,WorkBuddy 采用的分层是:所有任务都适用的角色与安全要求放 System Prompt,项目规范放 Workspace 规则文件,某类任务的步骤放 Skill,当前请求和进度作为动态上下文按需加入。
模型上下文协议(MCP):外部系统怎么标准化接入
到这里已经有了一个具备基础能力的 Agent,它能读写文件、运行脚本、执行命令等。但是用户在使用一个 Agent 产品的时候往往需要访问很多外部系统,例如读写 GitHub Issue/PR、访问外部文档、知识库、网盘等等。如果每接入一个系统都单独适配它的认证、接口、参数和返回格式,Agent 产品会很快变成一堆专用集成,维护成本很高。
MCP 试图解决的是外部能力接入的标准化问题。
Anthropic 在 2024 年底发布了开放协议 Model Context Protocol(MCP),用统一方式连接 AI 应用和外部数据源、工具。它为 AI 应用接入外部能力提供统一接口,Agent 不需要分别适配每个系统的调用方式。
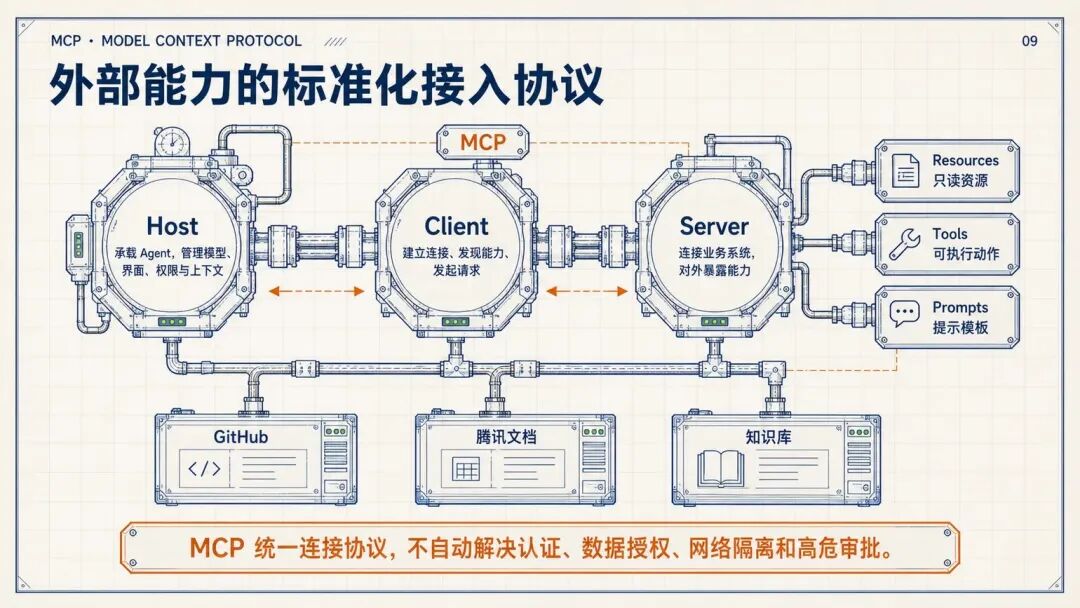
图:MCP 统一接入
多数用户对 MCP 的直接感知是“Agent 多了一批可调用的工具”。但它的名字是 Model Context Protocol 而不是 Model Tools Protocol,因为它提供的内容不限于工具。MCP Server 向 Agent 提供三种原语,关键差异在于谁来驱动:
• Resources(资源):有 URI 标识、可读取的只读内容(一个文件、一条数据库记录、一段实时数据)。它是应用 / Agent 驱动的——由 Agent 或用户决定何时读取、注入,本职用法是把读出的内容直接拼进 messages,不经过 tool。
• Tools(工具):模型能调用的动作 / 函数。它是模型驱动的——模型在推理时自己决定是否调用。结果通常以 text 回流进上下文供模型继续推理,但也可以把 structuredContent 分流给 UI 而不进上下文。
• Prompts(提示模板):Server 预先组织好、可复用的一组消息。它是用户驱动的——由用户主动点选(如斜杠命令)触发,模板内部还能引用 resource,把指令和文件内容打包带入。
这三类原语说明,MCP 处理的不是单一的“工具调用”,而是 Agent 与外部系统之间的信息、动作和提示模板如何被组织和传递。进一步看,外部系统返回的内容也不一定都要进入模型上下文:有些内容适合给模型阅读,有些内容更适合直接展示给用户,或者让用户在界面上确认和操作。
2026 年发布的官方扩展 MCP Apps 就是在这个方向上的延伸。它允许工具返回可直接渲染在对话中的交互式 UI,例如看板、图表、表单和确认界面。面向模型的摘要继续进入上下文,面向用户的界面数据直接交给 UI 渲染,不必全部塞进模型上下文。这样既保留了交互体验,也减少了上下文占用。
运行结构上,MCP 有三个角色:承载 Agent 的产品(如 WorkBuddy)、负责建连和发请求的 MCP Client、对外暴露能力的 MCP Server。MCP 统一的是连接协议,Server 背后仍可以是 REST、数据库、SDK,Agent 不需要理解这些差异。
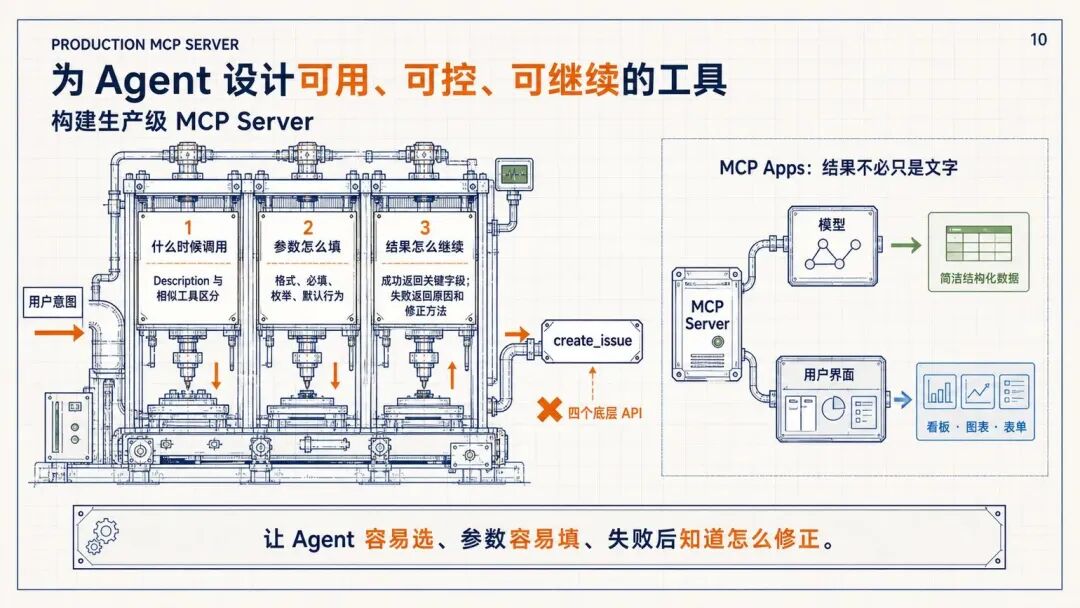
图:MCP 运行结构
关于 MCP Server,还有一个关键设计原则:**按用户意图组织工具,不照搬底层 API。**例如“创建 Issue”可能涉及创建、加描述、加 tag、加附件四个底层接口,但对 Agent 应该只暴露一个 create_issue工具,把描述、tag、附件作为参数。Issue 相关操作也可以收进一个工具,用不同 action(create / delete / update / close)区分。一个可用的工具至少要说明三件事:什么时候调用、参数怎么填、结果怎么继续处理。
Karpathy 在《Software Is Changing (Again)》里指出,Agent 是一类新的数字信息消费者和操作者。过去是人通过 GUI、程序通过 API 使用软件,现在多了一类介于两者之间的使用者。因此做产品时除了“人怎么点”,还要考虑“Agent 怎么理解、怎么操作、怎么验证”。
“Can we just build for agents?”(我们能只为 Agent 开发软件吗?)
Skill:一类任务该按什么流程做
有了 MCP 和 Tool,Agent 已经能调用很多外部能力。但真实任务通常不是调用一次工具就结束。所以还需要 skill。
以在某个仓库提交 PR 为例,它不止调一次 API——还要读仓库规则、执行测试、生成变更说明、处理失败,最后才创建。Skill 把这些经过验证的工作方法保存下来,通常包含说明、步骤、脚本、命令和判断标准。模型处理匹配任务时先读 Skill,再按流程执行:
适用场景:用户要求为当前仓库的代码变更创建 PR。流程:1. 读取 AGENTS.md / WORKBUDDY.md 和仓库贡献规范。2. 检查 git status,不覆盖用户的未提交修改。3. 阅读 diff,识别变更范围与风险。4. 运行与改动相关的格式化、类型检查和测试。5. 仅在验证通过后生成标题和描述,如实列出未验证项。6. 确认用户已授权发布,再 push 并创建 PR。完成标准:- PR 只包含本任务的变更。- 已记录所运行的测试与结果。- 标题、正文、Issue 关联符合团队规范。
Tool 负责“一个动作”,Skill 负责“一类任务的做法”。