目录
- Loop Engineering 是什么
- 为什么它会成为 Agent 时代的新重点
- 一个可用 Loop 应该怎么设计
- 案例:企业知识库问答的自修复循环
- Dify Loop 节点可以怎么理解
- 什么时候用,什么时候别用
摘要:我们经常会有一个疑问,为什么我们用的一些很热门的AI工具完成任务的成功率高于我们自己研发的AI工具,例如claudecode 或者trea这样的工具,主要原因是这些工具设计“让 AI 自己迭代、自己修正、自己逼近正确答案”的闭环系统,这就是 Loop Engineering。它不是简单的多轮对话,也不是让模型反复重试,而是把目标、状态、动作、反馈、终止条件和人工接管机制组织成一个可收敛的工作流。
本文将系统拆解 Loop Engineering 到底是什么、为什么它会成为 Agent 时代的重要能力、一个好用的 Loop 应该如何设计,并结合“智能问数”案例,说明 AI 如何从“生成 SQL”走向“校验结果、修正查询、输出可信分析”。同时,文章还会结合 Dify 官方文档与社区实现记录,解释 Loop 节点背后的核心原理,帮助你真正看懂:未来 AI 应用的竞争力,已经不只是模型能力,而是谁能把反馈循环工程化。
Loop Engineering 是什么
Loop Engineering不是让模型“多试几次”,而是把目标、上下文、动作、反馈、状态和终止条件组织成一个可重复执行的闭环系统。Kilo 这个AI 编程平台的官网上有一篇文章对它的定义很直接:这是设计、运行和持续优化反馈回路,让 AI Agent 能够规划、执行、观察结果并修正路径,直到任务真正完成。
LangChain 进一步把它放到更广的 Agent 架构里理解:最基础的一层是模型在上下文中调用工具并反复循环直到完成任务,而更成熟的系统还会在外面叠加验证循环、事件触发循环,甚至基于运行轨迹自动改进系统自身的“爬坡循环”。这说明 Loop Engineering 的重点,不在生成内容本身,而在让系统通过反馈不断逼近正确结果。
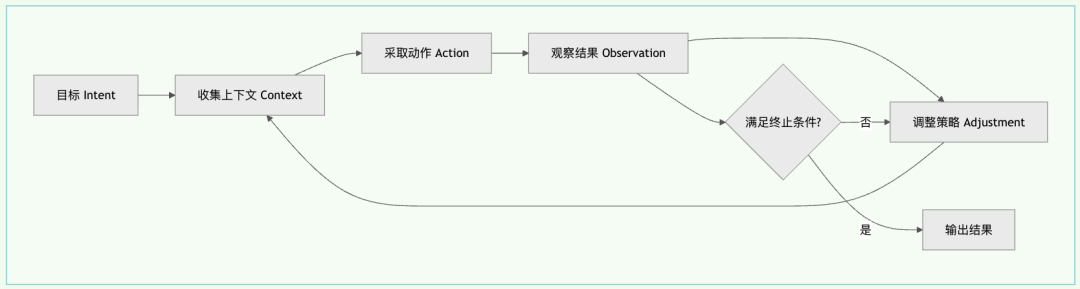
上图中Loop Engineering 的最小闭环,不是“一问一答”,而是“行动-反馈-修正”
如果说 Prompt Engineering 解决的是“第一句怎么问”,那么 Loop Engineering 解决的是“第一轮答得不够好之后,系统下一步怎么办”。
| 维度 | Prompt Engineering | Loop Engineering |
|---|---|---|
| 关注对象 | 一次输入如何写得更好 | 多轮执行如何逐步收敛 |
| 成功标准 | 首轮输出更像样 | 最终结果被验证为可用 |
| 核心反馈 | 主要依赖人工主观判断 | 依赖测试、评分器、日志、规则、人审 |
| 典型风险 | 回答看起来对,其实不可执行 | 循环设计差导致反复试错、不收敛 |
为什么它会成为 Agent 时代的新重点
原因很简单:真实的业务几乎都不是单轮完成的。 就比如我们开发代码,我们通常是先写一次,然后在自己的电脑环境或者开发环境运行,观察结果,根据结果,然后再调整代码,直到达到需求要求的细节和目标,因此在生产环境里的关键事实经常要在第一次动作之后才出现,比如测试失败、类型错误、运行日志、UI 截图问题或评审意见,这些后验信号才是真正推动系统修正的依据。
LangChain 也强调,Agent 的真正价值不只来自“模型会调用工具”,而来自如何在这个内循环外,再加上验证、事件触发和持续优化三层外循环。这意味着未来团队竞争的关键,不会只是用哪个模型,而是谁能把业务中的反馈链路工程化。
从 Dify 的产品演进也能看到这一点。官方把 Loop 和 Iteration 明确分开:Iteration 面向数组批处理,每个元素相互独立;Loop 面向渐进式迭代,每一轮依赖上一轮结果并通过持久变量维持状态。这其实就是把 Loop Engineering 的思想原生做进了可视化工作流。
一个可用 Loop 应该怎么设计
设计 Loop 时,最容易犯的错是把它理解成“失败就重试”。真正有效的 Loop,至少要同时回答七个问题。
1. 目标是否可验证
目标不能写成“让回答更好”,而要写成“答案必须引用知识库片段、缺失字段数为 0、质量分大于 85、最大重试 3 次”。没有可验证目标,就没有真正的闭环。Kilo 也把明确的成功标准列为优质 Loop 的首要条件。
2. 状态变量如何保存
Loop 不是每一轮都从零开始。你需要明确哪些变量会跨轮次延续,例如 draft\_answer、quality\_score、missing\_fields、retry\_count。Dify 官方文档特别强调,Loop 节点中的变量会跨轮次持久化,并在循环结束后继续可用。
3. 每一轮的动作是什么
动作通常只有几类:调用 LLM、调用工具、执行代码、查询接口、更新变量。动作设计要尽量小而清晰,不要在一轮里同时做太多事,否则一旦失败,很难判断是哪个假设错了。LangChain 对验证循环的建议,本质也是把每一轮拆到可以被判断、被纠偏的粒度。
4. 观察器或评分器是什么
Loop 能不能收敛,取决于你给它什么反馈。反馈可以来自规则判断、结构化校验、测试结果、人工审批,也可以是另一个 LLM 打分器。没有观察器,循环就只能瞎转。
5. 终止条件是否清晰
终止条件至少要有两层:业务终止和安全终止。业务终止表示“目标已满足”,安全终止表示“到达最大轮次,防止无限循环”。Dify 官方把 Loop Termination Condition、Maximum Loop Count、Exit Loop Node 三者同时作为退出机制。
6. 异常时谁接管
Loop 不应该掩盖不确定性,而应该暴露不确定性。比如缺少权限、外部接口超时、知识库无命中、评分器前后冲突,这些都应该让系统明确“升级到人工处理”,而不是继续空转。
7. 是否有回放与优化能力
好的LOOP不会只看一次结果,而会看每一轮的轨迹:哪一类任务容易在第 2 轮卡住,哪一种评估规则最容易误判,哪个提示模板让循环轮数下降。LangChain 把这种基于运行轨迹反向改造系统的过程称为“hill climbing loop”。
**一个实用模板:**目标 goal → 状态变量 state → 执行动作 act → 质量观察 observe → 更新变量 update → 判定退出 stop? → 人工接管 handoff
案例:智能问数的自修复循环
假设一家企业要做一个面向业务团队的智能问数助手。用户提出“上个月华东区销售额环比为什么下降”这类问题后,系统需要理解指标口径、生成查询、执行分析并给出解释。但企业很快会发现,单轮问数经常出现三种问题:字段理解错、SQL 结果不可靠、结论解释太泛。这个场景就很适合用 Loop Engineering。
业务目标
- 生成的查询必须通过字段校验、权限校验和时间口径校验
- 结果解释必须包含“核心结论、关键影响因子、可能异常点”三个部分
- 质量评分低于 85 分或 SQL 执行失败时自动修正
- 最多迭代 3 轮,超过后升级到人工
[登录查看剩余 70% 内容](javascript:void (0);)