 文章来源:phData blog《How to Create a Company "Brain" with Glean》(Marcus Montenegro,2025-10-27)
一、前言:一个刺眼的 5%
企业 AI 搞了这么多年,结果怎么样?
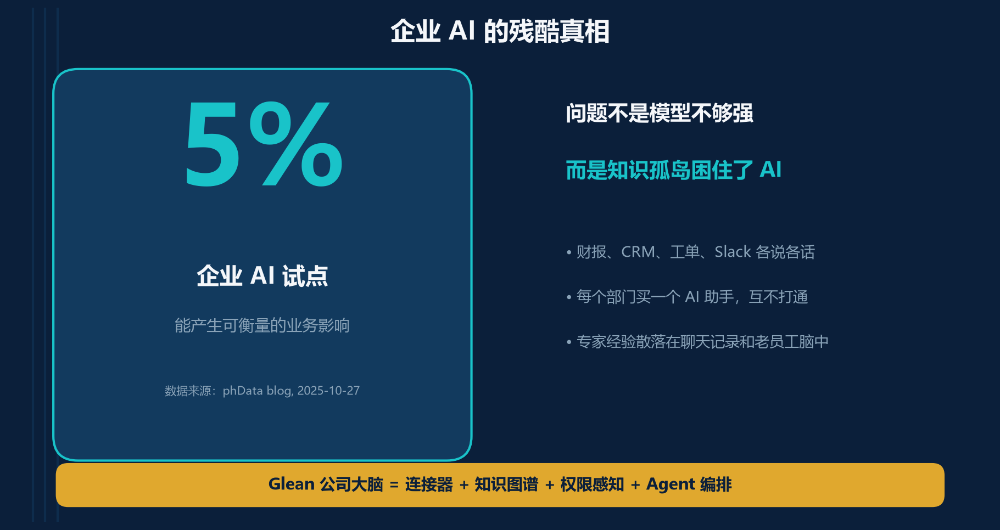
phData 在他们的数据与 AI 咨询实践中得出一个数字:只有 5% 的企业 AI 试点能真正产生可衡量的业务影响。 剩下的 95%,要么停在 Demo 里,要么用一阵子就被束之高阁。
这倒不是说模型不够强。GPT-4o、Claude Sonnet、Gemini 一个比一个能打,但企业落地时常常卡住。问题不是"AI 能不能答",而是"AI 知不知道公司在想什么"。
财报在 Excel 里,客户记录塞在 Salesforce 中,项目沟通散落在 Slack 和飞书,决策依据留在老员工的脑子里。每个部门还各自买了 AI 工具。结果是:AI 越多,知识越碎;模型越聪明,公司越像一群聋子在那各自喊话。
Glean 给出的方案,不是再堆一个聊天机器人。它要建一个公司大脑(Company Brain):把全公司数据、文档、对话、权限、人,织成一张统一的知识图谱,让 AI 真正理解这个组织。
二、背景:我们是怎么走进"AI 孤岛"的
phData 把企业的 AI 困境归结为一句话:知识孤岛养出了 AI 孤岛。
每个业务线都有自己的主战场。销售离不开 CRM,工程扎根在代码仓库和工单系统,市场围着内容管理系统和广告平台转,财务和 HR 各自守着 ERP。这些工具本身没问题,问题是它们互相不"认识"。
更麻烦的是,生成式 AI 爆发后,每个工具厂商都赶紧加了一个 AI 助手。Salesforce 有 Einstein,ServiceNow 有 AI 助手,GitHub 有 Copilot,Notion 也有 AI。每个助手都只能在自家数据里打转。你问"客户最近提了哪些需求?",销售 AI 只能看 CRM 里的记录,客服 AI 只能看到工单,产品 AI 只知道需求文档。同一个客户,在公司内部被切成了三四个碎片。
这就是"AI 孤岛":每个 AI 都局部聪明,但整体上谁也不比谁更了解公司。phData 认为,这种局面会导致三个具体损失:
沟通失真。部门 A 和部门 B 看的是不同版本的信息,开会时各说各话。一份客户反馈,销售记成"价格敏感",客服记成"功能缺失",产品只看到"优先级不高"。信息没有经过统一上下文,讨论就会失焦。
找东西的时间被浪费。员工为了回答一个问题,得打开三四个系统、翻十几个文档、问五六个人。phData 的调查显示,很多人一天里有相当一部分时间花在"找信息"上,而不是"用信息做决策"。
专家经验被埋没。某个技术难题,解决方案可能早就写在两年前的 Slack 线程里,但没人知道去哪找。久而久之,有经验的人离职,新员工重复踩坑,组织智商不升反降。
唯一的出路,不是换更多工具,而是建一个统一的工作 AI 平台。它给所有人一个入口,让搜索、创作、找专家、触发工作流都在同一个地方完成。
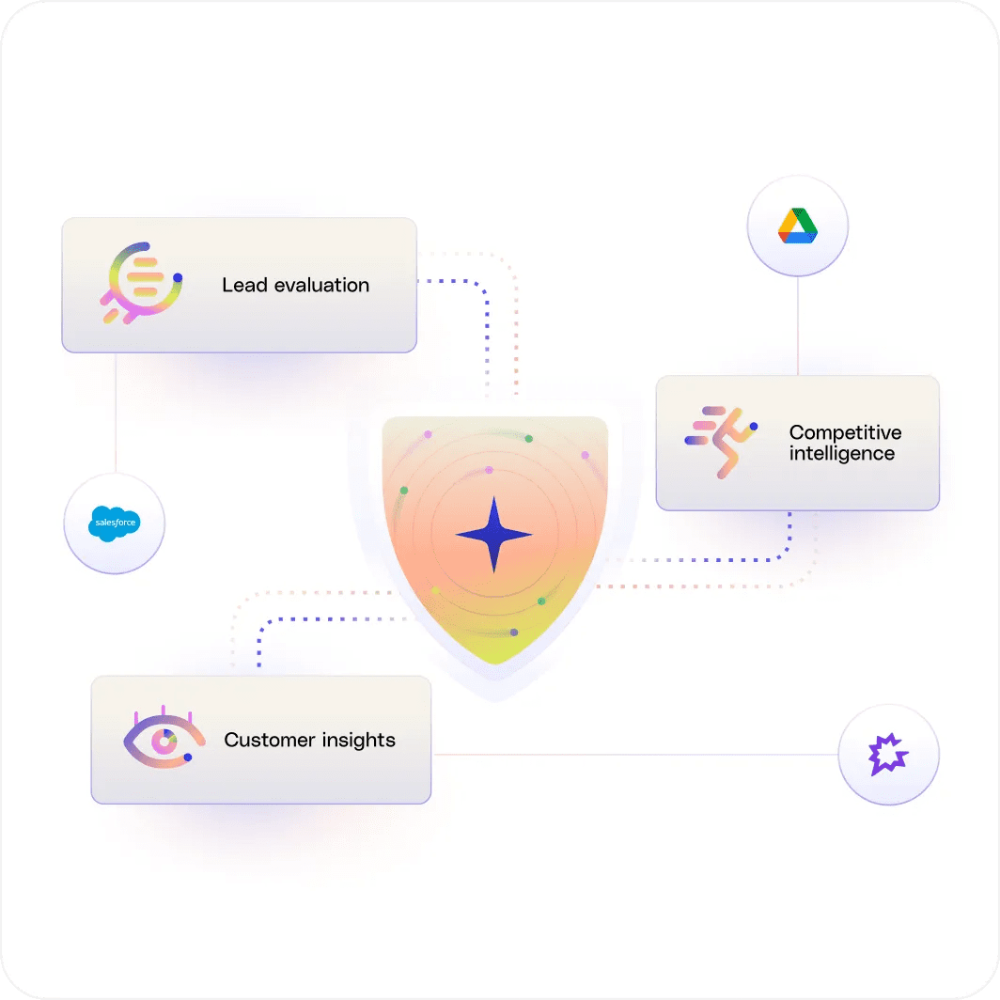
背景段(原图来源 phData blog)
三、方法:Glean 的"公司大脑"长什么样
Glean 是一家企业级 AI 平台。它的核心思路是:把企业里所有分散的数据,变成一张可被理解、可被引用、可被行动的知识图谱。
具体怎么做?分三步。
第一步:用连接器把数据接进来
Glean 通过原生连接器和自定义连接器,把企业里的文档库、即时消息、工单系统、CRM、代码仓库、数据库索引到一个统一的地方。phData 在文中举了自己的例子:他们的数据散落在 Snowflake、Google Docs、ServiceNow、Slack、Salesforce,甚至"人的脑子里"。Glean 的任务就是把这些数据源都接进来。
这里的连接器不是简单的搬运工。它会保留每个源系统的元数据:谁创建的、什么时候改的、属于哪个项目、关联哪些人。这些信息在后面构建知识图谱时至关重要。
第二步:复刻权限,做权限感知索引
这一步非常关键。Glean 不会把全公司数据"一锅炖"后让所有人都能搜。它复刻源系统的权限规则:用户只能看到自己在原系统里本来就能看的内容。查询时,这些访问规则会被实时执行。
这个设计给企业吃下了一颗定心丸。没有它,AI 搜索就变成了一场数据泄露事故。试想一下,如果普通员工能搜到高管邮件、薪酬数据、未发布的财报,再好的 AI 也没有意义。权限感知索引是 Glean 区别于普通 RAG 工具的核心安全机制。
第三步:用知识图谱而不是倒排索引理解信息
Glean 的底层不是传统搜索引擎的关键词索引,而是知识图谱。它的基本结构是三元组:主体(subject)— 谓词(predicate)— 客体(object)。
用人话说,它会把"张伟负责 Snowflake 项目"表达成 张伟 —[负责]→ Snowflake 项目。同样,"Snowflake 项目使用 phData 工具包"会表达成 Snowflake 项目 —[使用]→ phData 工具包。
这种结构让 Glean 能做多步推理。你问"phData 工具包被哪些项目用过?",系统能沿着图谱从 phData 工具包 反向找到 Snowflake 项目,再找到负责人 张伟。这种查询,传统关键词搜索很难做到,因为它不是靠关键词匹配,而是沿着"关系"一步步推理。向量检索能找出语义相似的文档,但无法回答"这个工具被哪些项目用过、由谁负责"这种多跳问题。
phData 特别指出,这种结构还能解决大语言模型的几个老毛病:实体歧义、实体混淆、精确事实召回困难。后面会详细讲。
两个图谱,一个大脑
Glean 把知识分成两层:
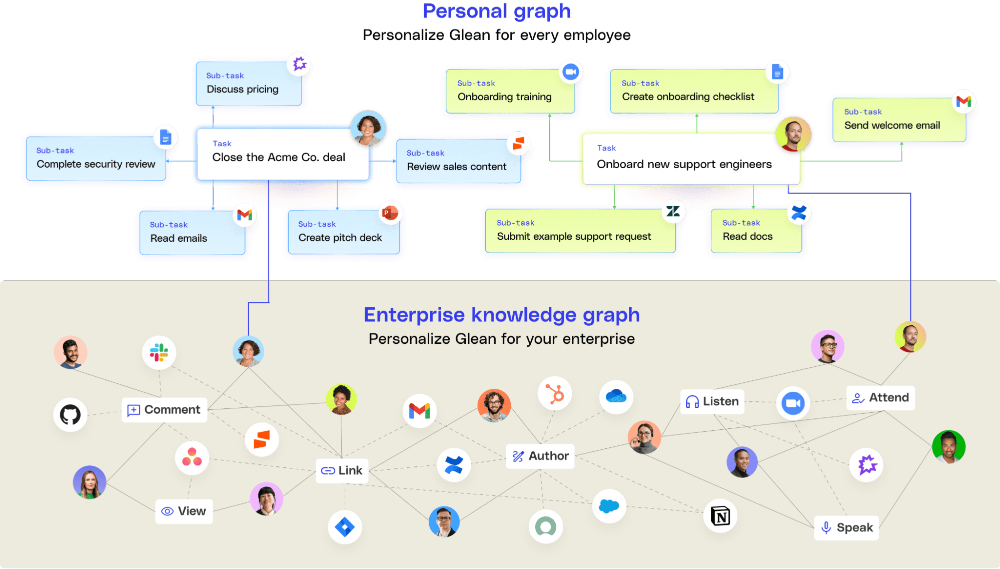
企业知识图谱(Enterprise Knowledge Graph):动态更新,理解公司的人、项目、流程和数据。它是组织的"公共记忆"。
个人图谱(Personal Graphs):基于每个人的工作习惯、协作对象、沟通风格,提供个性化的主动支持。比如 Assistant 能学习你的写作风格,自动起草邮件、安排会议,而且不需要你写复杂提示词。
只有这两层合在一起,AI 才既知道"公司发生了什么",也知道"你此刻需要知道什么"。
举个例子:你下周一要做一个项目汇报,Glean 的企业图谱知道这个项目涉及哪些文档、哪些人和哪些历史决策;个人图谱知道你喜欢用什么格式、通常关注哪些指标、平时和谁协作。于是它给你的不是一份泛泛的搜索结果,而是一页按你风格整理好的汇报草稿。
方法段(原图来源 phData blog)
四、结果:当公司有了"结缔组织"
Glean 反复强调,公司大脑不只是一个更聪明的搜索框。它是企业 AI 的结缔组织:把所有应用、数据、流程、人串在一起,让 AI 按照企业的真实运作方式工作。
phData 列出了几个可衡量的业务结果:
减少跨部门沟通误解。当所有人都能基于同一个信息源回答问题时,开会不再是"你听到的版本"和"我听到的版本"之争。
节省大量查找信息的时间。员工不用再打开四五个系统反复检索,一个自然语言提问就能直达答案。
发现隐藏的专家。系统自动识别谁在某个话题上最有经验。对新人尤其有价值:他们不用猜"这事该问谁",系统直接把人推出来。专家发现的价值不仅在于找人,更在于把隐性知识变成可调用资产。过去,一个资深工程师离职,他脑子里的大量经验就带走了。现在,这些经验可以通过 Agent 被编码、被搜索、被复用。公司不再怕"人走了就断层"。
自动化重复工作。通过 Agent 接管流程,比如自动生成周报、汇总客户动态、跟进安全问卷。
创建主题助手。为法务、安全、BI、销售、人力资源等特定领域建立专业 Agent,让专家知识可以 7×24 被调用。
这些收益听起来抽象,但放在具体场景里就变得很真实。比如一个新销售想快速了解某客户的历史,他不再需要同时打开 CRM、邮件、Slack 和共享盘,问 Glean 一句就能拿到带引用的完整时间线。一个安全合规人员收到外部问卷,也不用翻遍政策文档,Agent 能直接基于最新制度给出答复。一个项目经理要组建新团队,系统能推荐有相关经验、且当前负载合理的人。
更进一步,Glean 设计了 "观察—学习—改进"循环(observe, learn, improve)。工作流被持续监测,瓶颈被识别,下一步最优动作被自动执行。价值不是一次性的,而是复合增长。更重要的是,这些收益会随着时间的推移而放大。知识图谱在越用越准,Agent 在越用越聪明,员工在越用越省时间。它不是一次性的工具采购,而是一个持续增值的企业资产。
phData 给出的是一个清晰的逻辑:AI 系统如果能"记住"公司,就能持续减少摩擦成本。
结果段(原图来源 phData blog)
五、专家解读:知识图谱为什么是大模型的"解药"
phData 作为长期服务企业的数据与 AI 咨询公司,对 Glean 的评价很高。他们认为,Glean 真正的护城河不是搜索速度快,而是用知识图谱解决大语言模型的结构性弱点。
大模型在企业环境里有三个软肋:
第一,歧义(Ambiguity)。同一个词在不同部门含义不同。"项目 Alpha" 在销售、工程、财务里可能指完全不同的三件事。纯靠文本搜索,AI 会张冠李戴。
第二,实体混淆(Entity Conflation)。张经理、张总、张伟,可能是同一个人,也可能是三个人。文本模型不擅长区分这些。
第三,精确事实召回。LLM 不是数据库。它记不太清准确数字、权限边界和具体条款。让它"硬背"公司制度,效果不会好。
知识图谱的三元组结构,把模糊文本变成结构化关系。它不是替代 LLM,而是给 LLM 提供一份"地图"和一份"参考书"。
Glean 的回答都带透明引用。你看到一个答案,可以点回原文出处。这个设计很重要:它不是说 AI 不会错,而是让错误变得可被追溯、可被纠正。
在企业里,实体歧义比比皆是。一份合同里的"甲方"可能指公司总部,也可能指某个子公司;一个产品代号可能在不同部门指不同版本。Glean 通过图谱把实体与其上下文绑定,让 LLM 在回答前先明确"说的是谁"。这就好比给 AI 装了一部企业版百科全书,而不是让它凭空背诵。
从专业角度看,这正是检索增强生成(RAG)在企业场景里的高级形态。普通 RAG 把文档切片扔进向量库,靠语义相似度召回。它的好处是简单、通用,但缺点是容易丢失上下文,召回回来的是"看起来像答案"的片段,而不是"确实是答案"的事实。
Glean 的图谱 RAG 则基于实体关系推理。它先理解问题里的实体,再在知识图谱里定位这些实体及其关系,最后把相关上下文喂给 LLM。召回更精准,解释也更清楚。
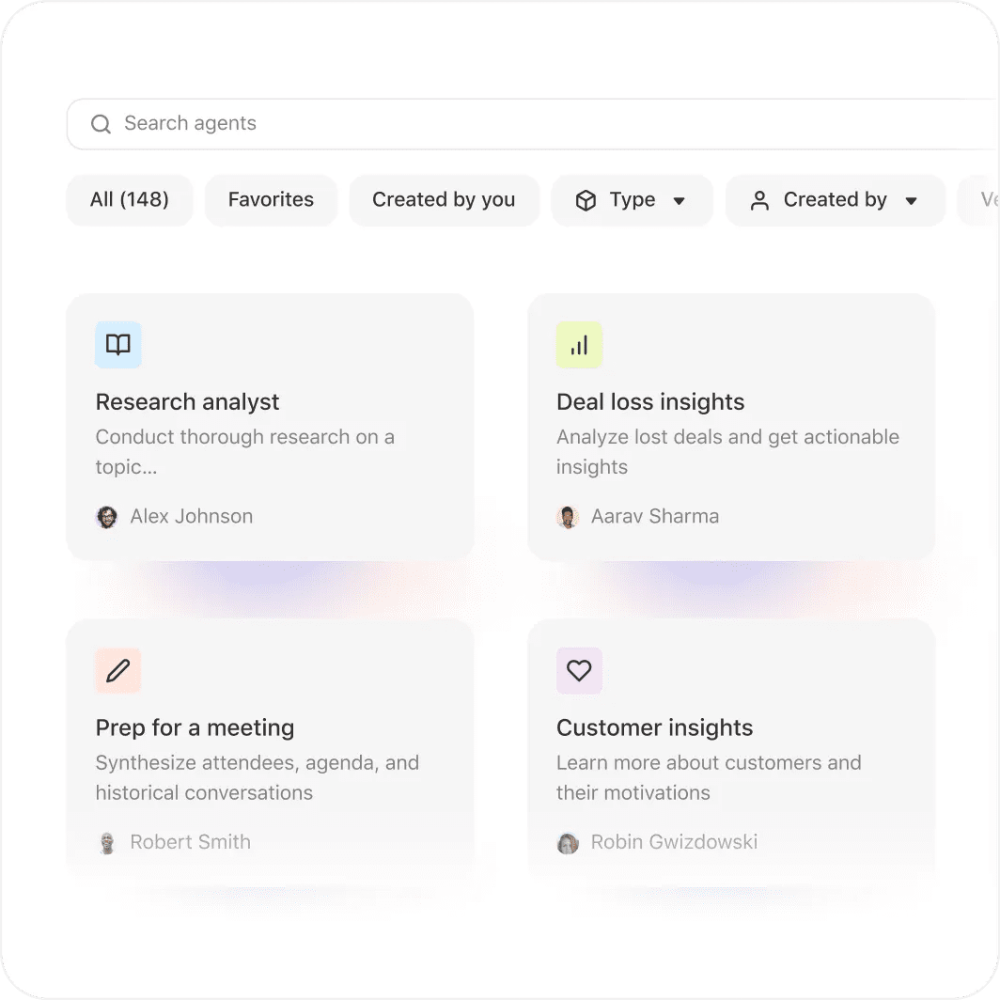
专家解读段(原图来源 phData blog)
六、产业影响:Glean 想做企业 AI 的"中央神经系统"
Glean 的野心,不是替代你现有的 AI 工具,而是成为它们的中枢神经系统。
它的 Agent 可以通过聊天界面、定时任务、API 调用、网页嵌入等多种方式被消费。这意味着:你已有的 Sales AI、Coding AI、BI 工具,都可以接入 Glean 的集中知识库,获得跨系统的上下文。
用 phData 的话说:"你可以用强大的知识引擎,同时仍然保留那些必须保留的遗留或专用方案。"
这个定位非常清晰。它不像 Microsoft Copilot 那样深度绑定 Office 生态,也不像 Palantir AIP 那样面向高复杂度决策场景。Glean 选择的是横向、平台无关路线:它不做某个垂直场景的最强工具,而是做所有工具之间的"语义层"。
如果这条路线走通,Glean 将成为企业 AI 栈里不可或缺的中间层。它收集数据、理解语义、管理权限,然后为上层各种 AI 应用提供干净的上下文。
对 CIO 和架构师来说,这意味着:未来的企业 AI 架构可能从"每个工具自带 AI"变成"一个中央知识层 + 多个垂直执行器"。Glean 负责理解上下文和权限,上层工具负责各自擅长的事。这种分层比每个工具都自建一套知识库要干净得多。
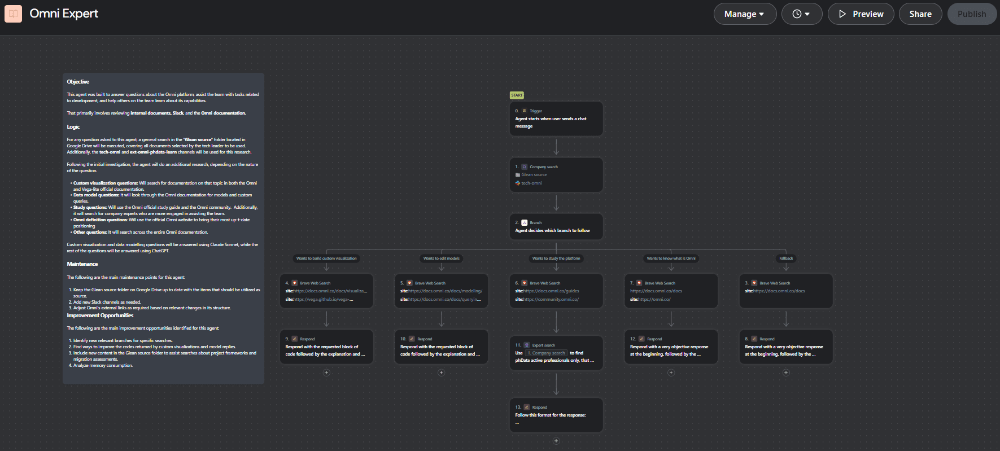
产业影响段(原图来源 phData blog)
七、局限与争议:每个"大脑"都有门槛
Glean 的方案听起来理想,但落地并非没有门槛。
第一,数据治理得先过关。 Glean 复刻源系统权限,但它不修复权限混乱。如果公司在数据访问、分类、生命周期管理上本来就一团糟,接入 Glean 只会把混乱放大。换句话说,Glean 是放大镜,不是清洁剂。
第二,幻觉没有消失。 知识图谱能降低错误率,但 LLM 生成部分仍然可能"一本正经地胡说"。引用机制让错误更可追溯,但不是说 AI 永远不会错。尤其是当图谱本身有错误、关系过时的时候,AI 会跟着错。
第三,成本与复杂度。 连接器、索引、图谱、Agent 编排、权限同步——这一套对企业 IT 架构和预算都是考验。小公司或数据基础薄弱的公司,可能一时半会儿玩不转。部署不是一天两天,而是持续的运维。
第四,供应商锁定风险。 一旦全公司知识都沉淀在 Glean 的图谱里,迁移成本会很高。这是所有"平台级"产品的共同宿命。
第五,"企业超智能"(enterprise superintelligence)这个词可能过誉。 在真实组织里,知识不是越集中越好。过度集中可能压制部门自主性,甚至让错误决策更快传播。Glean 给的只是一种技术可能,组织能不能用好,是另一回事。
局限争议段(原图来源 phData blog)
八、同类对比:Glean 站在哪里
Glean 的核心差异是横向(horizontal)平台无关策略。把它和同类产品放在一起,位置很清楚。
Microsoft 365 Copilot / Google Workspace AI:深度绑定自家生态。在 Office 或 Workspace 里的体验最好,但跨出生态就明显变弱。如果你公司主要用微软服务,Copilot 的局部体验可能更顺滑。
垂直工具(如 Salesforce Einstein、ServiceNow AI):在各自场景里很强,但企业-wide 需求覆盖不足。它们适合解决特定问题,但难以成为"公司大脑"。
Palantir AIP:强调 Ontology 与本体论,适合高复杂度、高风险的决策场景(如国防、金融、医疗)。部署和成本也更重。
Notion / Confluence AI:擅长文档和知识库,但缺少真正的连接器生态和权限感知。它更像一个"知识库",不是"公司大脑"。
Glean:不跟任何一家应用强绑定,而是把企业的异构数据统一起来。这种定位在"多应用混战"的大企业里最有价值。
选择哪一种,取决于企业的数据现状。如果公司已经深度绑定某一家生态,垂直方案可能更顺手,短期部署成本更低。如果公司是"万国牌"应用堆起来的,Glean 的横向路线更合理。因为它不假设你的数据都在一个地方,而是接受"数据本来就散"这个现实,并试图在之上建一个统一的语义层。
九、结尾:公司大脑不是产品,是一种组织能力
回到开头那个 5% 的数字。
企业 AI 失败,很少是因为模型不够聪明。更多时候,是因为公司自己的知识先碎了。AI 只能记住你让它记住的东西;如果知识分散在 100 个应用里,AI 也只会跟着你一起迷路。
Glean 的"公司大脑"本质上是在回答一个问题:如何让组织像一个人一样记住和思考?
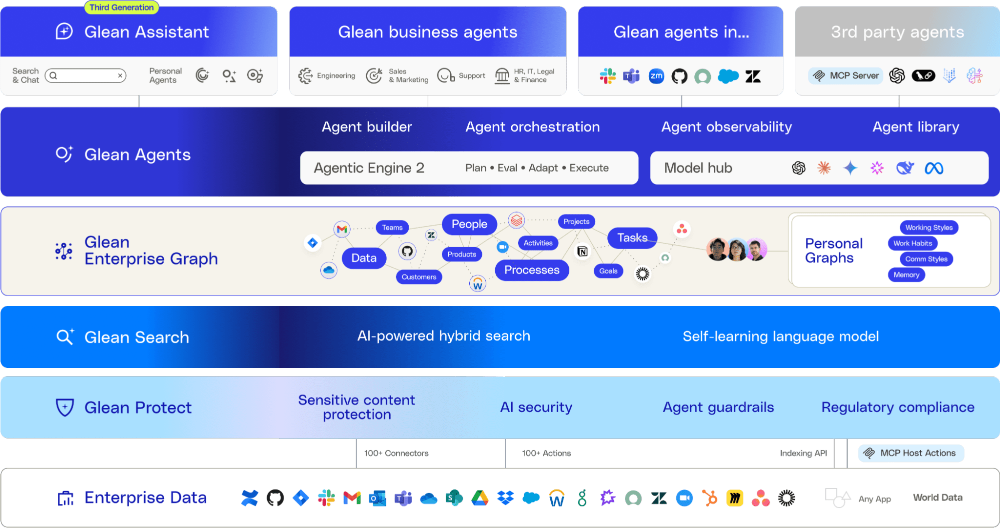
技术答案也许很清晰:连接器、知识图谱、权限感知、Agent 编排。但组织答案更难:它要求先承认数据孤岛的存在,然后舍得花时间打通它。这涉及数据治理、权限梳理、流程规范,甚至文化改变。
这可能不是一年两年的项目。但当数据、流程、权限、人都被织进同一张图里,公司的决策速度、新人流失速度、跨部门协作成本,都会发生质变。
说到底,Glean 只是一个工具。真正的"公司大脑",是企业愿意持续治理自己的知识、打破部门墙、让数据流动起来。这种能力,短期内看不见,长期却是一家公司最不容易被复制的竞争力。
到那时,公司才真正会思考。
[登录查看剩余 70% 内容](javascript:void (0);)